大型AI计算机服务器中心 计算机系统服务的基石与演进
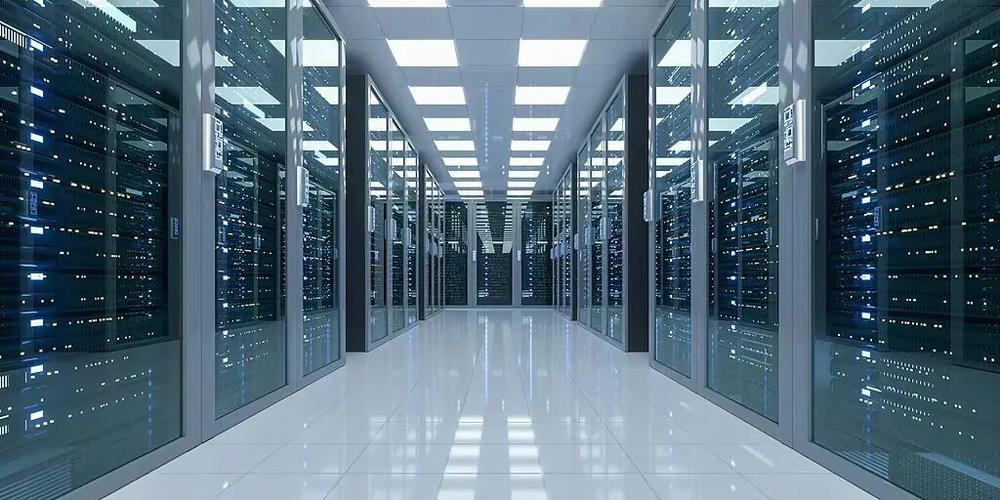
随着人工智能技术的飞速发展,大型AI计算机服务器中心已成为支撑数字经济的重要基础设施。这些中心不仅承载着海量数据的处理与模型训练任务,更通过高效的计算机系统服务,为各行各业提供智能化的算力支持。本文将从大型AI服务器中心的架构特点出发,探讨计算机系统服务在其中扮演的关键角色及其发展趋势。
一、大型AI服务器中心的架构特点
大型AI服务器中心通常由数千甚至数万台高性能计算节点组成,配备GPU、TPU等专用加速芯片,以满足深度学习模型训练和推理的算力需求。其架构设计强调高密度、高能效和可扩展性,通过高速网络互连实现节点间的协同计算。中心还部署了先进的冷却系统和电源管理方案,确保设备稳定运行并降低能耗。这种集中化的算力资源池化模式,使得AI计算能力可以像水电一样按需分配,极大提升了资源利用率。
二、计算机系统服务的核心内容
计算机系统服务是大型AI服务器中心高效运转的“软件灵魂”。它涵盖了从硬件抽象、资源调度到应用支撑的全栈服务,主要包括以下几个方面:
- 资源管理与调度:通过容器化、虚拟化技术对计算、存储、网络资源进行统一池化,并借助Kubernetes等编排工具实现任务的动态分配与弹性伸缩。针对AI负载的特性,调度系统需考虑GPU拓扑、内存带宽等因素,以最大化并行效率。
- 分布式存储与数据服务:AI训练需要高速读写海量数据集,因此分布式文件系统和对象存储服务至关重要。系统需提供高吞吐、低延迟的数据访问接口,并支持数据版本管理、缓存加速等功能,以缩短数据准备时间。
- 模型训练与推理服务:提供深度学习框架(如TensorFlow、PyTorch)的运行时环境,集成分布式训练通信库(如NCCL),并支持模型开发、调试、部署的全生命周期管理。推理服务则通过模型优化、批处理等技术提升响应效率。
- 运维监控与安全服务:建立全面的监控体系,实时追踪硬件状态、任务性能与能耗指标,实现故障预测与自动恢复。通过身份认证、访问控制、数据加密等手段保障系统安全,防止算力资源滥用和数据泄露。
三、计算机系统服务的关键挑战与创新
在大型AI服务器中心中,计算机系统服务面临诸多挑战:一是算力异构化增加了资源管理的复杂度;二是AI任务的大规模并行对网络和存储提出更高要求;三是能效优化成为降低运营成本的关键。为应对这些挑战,业界不断推动技术创新,例如:
- 采用RDMA(远程直接内存访问)网络技术降低通信延迟;
- 引入液冷散热与AI驱动的能效管理算法;
- 发展基于Serverless的AI推理服务,实现细粒度资源按需使用;
- 构建MLOps平台,打通模型开发与运维的壁垒。
四、未来展望
随着大模型和生成式AI的普及,大型AI计算机服务器中心将向更大规模、更高能效、更智能化的方向演进。计算机系统服务也将更加注重跨中心协同、算力网络融合以及绿色低碳。通过软硬件协同优化和云原生技术的深度应用,AI服务器中心有望成为像公共电网一样便捷的社会化算力基础设施,为科学研究、产业升级和智慧生活提供强有力的支撑。
大型AI计算机服务器中心是AI时代的算力底座,而计算机系统服务则是释放其潜能的核心引擎。只有持续创新系统服务技术,才能让大规模算力真正转化为生产力,推动人工智能技术在千行百业落地生根。
如若转载,请注明出处:http://www.wriquo.com/product/23.html
更新时间:2026-11-01 02:28:06